Wie RAG funktioniert: Grundlagen, Vorteile und Einsatzmöglichkeiten
Künstliche Intelligenz kann Fragen beantworten, Texte erstellen und große Datenmengen verarbeiten. Doch sobald es um interne Unternehmensdaten, aktuelle Dokumente oder spezielles Fachwissen geht, stoßen klassische KI-Modelle häufig an ihre Grenzen. Retrieval Augmented Generation (RAG) verbindet generative KI mit externen Wissensquellen und ermöglicht Antworten auf Grundlage aktueller, relevanter Informationen.
Unternehmen können damit ihr Wissen schneller abrufen, Kundenanfragen beantworten und umfangreiche Dokumentationen effizienter durchsuchen. Entscheidend ist dabei nicht allein das KI-Modell, sondern wie zuverlässig die benötigten Inhalte gefunden und verarbeitet werden.
Was ist Retrieval Augmented Generation (RAG)?
Retrieval Augmented Generation, kurz RAG, ist ein technischer Ansatz, bei dem ein KI-Sprachmodell (Large Language Model, LLM) vor der Erstellung einer Antwort zusätzliche Inhalte aus externen Datenquellen erhält.
Der Begriff beschreibt drei aufeinanderfolgende Vorgänge:
- Retrieval (Abrufen): Das System sucht nach relevanten Inhalten in angebundenen Wissensquellen.
- Augmented (Erweitern): Die gefundenen Daten werden der ursprünglichen Anfrage als zusätzlicher Kontext hinzugefügt.
- Generation (Generieren): Das Sprachmodell verwendet diesen Kontext, um eine passende Antwort zu formulieren.
Ein klassisches Large Language Model greift bei einer Anfrage hauptsächlich auf die während des Trainings erlernten Zusammenhänge und den bereitgestellten Gesprächskontext zurück. Es kennt deshalb weder automatisch die internen Arbeitsanweisungen eines Unternehmens noch dessen aktuelle Produktdaten oder individuelle Vertragsbedingungen.
RAG erweitert den Kontext einer Anfrage durch relevante Inhalte aus einer angebundenen Wissensdatenbank (Knowledge Base). Das Sprachmodell kann diese zusätzlichen Informationen anschließend bei der Erstellung seiner Antwort berücksichtigen.
| Das Besondere: Das KI-Modell muss dafür nicht mit den Unternehmensdaten neu trainiert werden. Die benötigten Informationen werden bei jeder Anfrage gezielt abgerufen und dem Modell zur Verfügung gestellt. |
So können bestehende Language Models auf unternehmensspezifisches Wissen zugreifen, ohne dass ihre grundlegende Funktionsweise verändert werden muss.
Wie funktioniert Retrieval Augmented Generation?
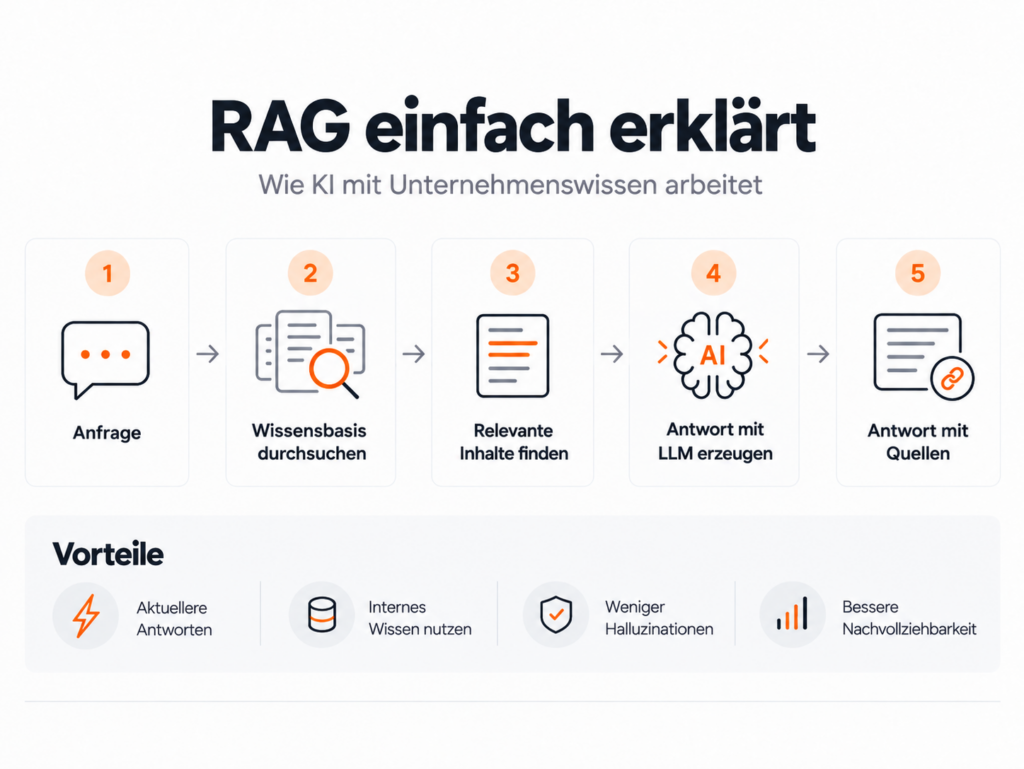
Ein RAG-System verbindet eine Suchtechnologie mit generativer künstlicher Intelligenz. Dafür wird zunächst eine Wissensbasis vorbereitet, aus der das System bei einer Nutzeranfrage passende Inhalte abruft.
Der technische Ablauf lässt sich in mehrere Schritte unterteilen:
1. Datenquellen anbinden und Inhalte aufbereiten
Zunächst wird festgelegt, auf welche Datenquellen das System zugreifen soll. Dazu können PDF-Dateien, Word-Dokumente, technische Handbücher, interne Knowledge Bases, Datenbanken oder bestehende Softwareanwendungen gehören.
Die Dokumente werden technisch verarbeitet und häufig in kleinere, zusammenhängende Textabschnitte aufgeteilt. Dieser Vorgang wird als Chunking bezeichnet. Dadurch kann die Suche gezielt relevante Passagen finden, anstatt ganze Dokumente an das Sprachmodell zu übergeben.
2. Daten für die semantische Suche vorbereiten
Bei vielen RAG-Architekturen werden die Textabschnitte in sogenannte Embeddings umgewandelt.
Ein Embedding ist eine mathematische Darstellung eines Textes, die dessen inhaltliche Bedeutung abbilden soll. Inhaltlich ähnliche Texte können dadurch auch dann gefunden werden, wenn sie unterschiedliche Begriffe verwenden. Die Embeddings lassen sich in einer Vektordatenbank speichern und für die semantische Suche verwenden.
3. Die Nutzeranfrage analysieren
Stellt ein User eine Frage, verarbeitet das RAG-System zunächst die Eingabe.
Die Suchanfrage kann beispielsweise lauten:
„Welche Schritte sind für die Freigabe einer Bestellung erforderlich?“
Das System sucht nun nach Daten, die inhaltlich zu dieser Frage passen. Dabei können auch Dokumente gefunden werden, die andere Begriffe wie „Genehmigungsprozess“ oder „Bestellfreigabe“ verwenden.
4. Relevante Inhalte abrufen
Die Retrieval-Komponente ermittelt passende Textabschnitte aus der Wissensbasis. Je nach Architektur kommen dafür semantische Suche, klassische Keyword Search oder kombinierte Suchverfahren zum Einsatz. Anschließend werden die gefundenen Passagen gemeinsam mit der Anfrage an das Sprachmodell übergeben.
5. Antworten generieren und Quellen bereitstellen
Das LLM erstellt aus dem bereitgestellten Kontext eine verständliche Antwort. Ein entsprechend entwickeltes RAG-System kann zusätzlich die verwendeten Dokumente oder konkreten Textstellen anzeigen. Wenn eine Antwort auf den abgerufenen Quellen basiert, spricht man auch von einer quellengestützten Antwort (Grounded Response). Werden die verwendeten Quellen zusätzlich angezeigt, können Nutzer die Aussagen leichter überprüfen.
Die Qualität hängt jedoch davon ab, ob die Suche die richtigen Inhalte findet und das Sprachmodell diese korrekt verarbeitet. Eine funktionierende Suche garantiert deshalb noch keine fachlich richtige Antwort.
Praxisbeispiel: Mit RAG interne Unternehmensdaten durchsuchen
Angenommen, ein Unternehmen verwaltet mehrere Tausend Dokumente, darunter technische Anleitungen, Prozessbeschreibungen und interne Richtlinien.
Mitarbeiter müssen bislang verschiedene Ordner und Anwendungen durchsuchen, um die benötigten Informationen zusammenzutragen.
Ein RAG-basierter KI-Assistent könnte diesen Ablauf vereinfachen.
Ein Mitarbeiter fragt beispielsweise:
„Welche Voraussetzungen gelten für die Wartung unserer Anlage und welche Schritte müssen dokumentiert werden?“
Das System durchsucht die freigegebenen Unterlagen, findet relevante Wartungsvorgaben und erstellt eine verständliche Zusammenfassung. Idealerweise werden die Quelldokumente direkt verlinkt.
Der Mitarbeiter erhält damit eine konkrete Antwort samt Quellen, ohne mehrere Handbücher einzeln durchsuchen zu müssen.
Ändert sich eine Wartungsanweisung, kann die aktualisierte Version in die Wissensbasis übernommen werden.
Das Beispiel zeigt den wesentlichen Nutzen von RAG: Vorhandenes Unternehmenswissen wird über natürliche Sprache schneller und gezielter zugänglich.
Gerade bei sicherheitsrelevanten Anweisungen bleibt die fachliche Prüfung jedoch notwendig.
Welche Vorteile bietet Retrieval Augmented Generation für Unternehmen?
RAG ist besonders interessant, wenn Unternehmen umfangreiche Wissensbestände verwalten und regelmäßig darauf zugreifen müssen.
Der Mehrwert liegt darin, relevante Informationen schnell zu finden und für konkrete Aufgaben nutzbar zu machen.
Schnellerer Zugriff auf Unternehmenswissen
Mitarbeiter müssen nicht mehr jedes Dokument manuell durchsuchen. Ein RAG-System kann relevante Inhalte aus unterschiedlichen Quellen zusammenführen und verständlich aufbereiten.
Aktuellere Antworten durch eine gepflegte Knowledge Base
Aktualisierte Dokumente können in die Wissensbasis übernommen werden, ohne das Sprachmodell neu zu trainieren. Wie schnell Änderungen verfügbar sind, hängt von der Synchronisierung der Quellen ab.
Geringeres Risiko für erfundene Antworten
Generative KI kann plausible, aber sachlich falsche Aussagen erzeugen. Dieses Phänomen wird als Halluzination bezeichnet.
RAG kann das Risiko von Halluzinationen reduzieren, indem dem Sprachmodell relevante Quellen als Grundlage für seine Antworten bereitgestellt werden. Voraussetzung ist, dass diese korrekt ausgewählt und verarbeitet werden.
Unterstützung bei wiederkehrenden Fragen
Bei häufigen Fragen zu internen Abläufen oder technischen Produkten kann ein RAG-System Mitarbeiter entlasten und die Bearbeitung vereinheitlichen.
Nachvollziehbarkeit durch Quellenangaben
Quellenverweise ermöglichen es, Antworten direkt mit den zugrunde liegenden Dokumenten abzugleichen, was die fachliche Kontrolle erheblich erleichtern kann.
Nutzung bestehender KI-Modelle
Unternehmen müssen nicht zwingend ein eigenes Large Language Model entwickeln oder trainieren, sondern können bestehende LLMs mit einer individuell aufgebauten Wissensbasis verbinden.
Ob dadurch tatsächlich Zeit und Kosten eingespart werden, hängt vom konkreten Anwendungsfall, der Datenqualität und dem technischen Aufwand ab.
Wo wird RAG in Unternehmen eingesetzt?
Retrieval Augmented Generation eignet sich besonders für Anwendungen, bei denen Antworten auf umfangreichen, sich verändernden oder unternehmensspezifischen Daten beruhen müssen.
Zu den typischen Einsatzmöglichkeiten gehören:
Interne Wissensmanagement-Systeme
Arbeitsanweisungen, Projektdokumentationen und Unternehmensrichtlinien werden über eine KI-gestützte Suche zugänglich. Mitarbeiter stellen konkrete Fragen, anstatt sich durch Ordnerstrukturen zu arbeiten.
Kundenservice und technische Unterstützung
Ein RAG-Chatbot kann Produktinformationen, Supportdokumentationen und häufig gestellte Fragen durchsuchen. Auf dieser Grundlage kann der RAG-Chatbot passende Antworten erstellen. Je nach technischer Umsetzung können einfache Kundenanfragen auch automatisiert beantwortet werden.
Softwareentwicklung und IT-Dokumentation
Entwicklungsteams können interne API-Dokumentationen, technische Spezifikationen und Architekturentscheidungen durchsuchen. Eine zentrale Datenbank (Knowledge Base) kann dabei die Einarbeitung, technische Recherche und Fehlersuche erleichtern.
Personalwesen und Onboarding
Neue Mitarbeiter können Fragen zu internen Abläufen, organisatorischen Regelungen oder Schulungsunterlagen stellen. Voraussetzung ist, dass die zugrunde liegenden Dokumente aktuell und für die jeweilige Person freigegeben sind.
Produkt- und Unternehmensdaten
Technische Datenblätter, Produktkataloge und interne Beschreibungen lassen sich für Vertrieb und Service über eine gemeinsame Suchoberfläche verfügbar machen.
Diese Anwendungen haben eines gemeinsam: Das benötigte Wissen existiert bereits. Es muss zuverlässig gefunden und sinnvoll verwendet werden.
RAG vs. Fine-Tuning: Wo liegt der Unterschied?
Unternehmen, die generative KI an ihre Anforderungen anpassen möchten, begegnen häufig zwei Begriffen: Retrieval Augmented Generation und Fine-Tuning.
Beide Ansätze verbessern die Nutzbarkeit von KI-Modellen, verfolgen aber unterschiedliche Ziele.
| Kriterium | RAG | Fine-Tuning |
| Grundprinzip | Ergänzt Anfragen mit externen Daten | Passt die Modellparameter durch zusätzliches Training an |
| Unternehmenswissen | Wird aus angebundenen Quellen abgerufen | Kann durch Trainingsbeispiele beeinflusst werden |
| Aktualisierung | Neue Inhalte können über die Wissensbasis bereitgestellt werden. | Änderungen am trainierten Modellverhalten können weiteres Training erfordern. |
| Typische Verwendung | Dokumentensuche, Wissensassistenten, aktuelle Daten | Spezielle Ausgabeformate, Aufgaben oder Verhaltensmuster |
| Quellenangaben | Können aus abgerufenen Dokumenten bereitgestellt werden | Sind nicht automatisch Bestandteil des Verfahrens |
| Technischer Aufwand | Abhängig von Datenaufbereitung, Search und Integration | Abhängig von Trainingsdaten, Modell und Evaluierung |
Soll eine KI aktuelle technische Angaben aus Unternehmenshandbüchern beantworten, ist RAG häufig die passende Lösung. Soll sie dagegen ein bestimmtes Ausgabeformat besonders zuverlässig beherrschen, kann Fine-Tuning sinnvoll sein.
Beide Verfahren lassen sich kombinieren: Ein angepasstes Language Model kann weiterhin auf externe Wissensquellen zugreifen.
Fine-Tuning ersetzt somit keine gepflegte Wissensbasis. RAG wiederum verändert nicht automatisch die Fähigkeiten eines Sprachmodells.
Welche Rolle spielen Vektordatenbanken und semantische Suche?
Die Suche ist ein zentraler Bestandteil jeder RAG-Architektur.
Eine klassische Stichwortsuche findet Dokumente anhand konkreter Begriffe. Das funktioniert beispielsweise bei Produktnummern oder eindeutigen Fachbezeichnungen.
Bei natürlich formulierten Fragen ist jedoch häufig eine Suche nach inhaltlicher Bedeutung erforderlich.
Sucht ein Mitarbeiter nach „Urlaub beantragen“, während ein Dokument von „Abwesenheitsgenehmigung“ spricht, kann eine semantische Suche den Zusammenhang mithilfe von Embeddings erkennen.
Je nach Anwendung kommen unterschiedliche Search-Verfahren infrage:
- Keyword Search: Sucht nach konkreten Begriffen und Zeichenfolgen.
- Semantic Search: Vergleicht die inhaltliche Bedeutung von Texten.
- Hybrid Search: Kombiniert klassische und semantische Suchverfahren.
- Reranking: Bewertet gefundene Treffer erneut, um besonders relevante Ergebnisse auszuwählen.
Nicht jedes RAG-System benötigt dafür eine eigenständige Vektordatenbank. Auch Volltextsuche, relationale Datenbanken oder direkte Abfragen bestehender Anwendungen können sinnvoll sein. Gerade bei exakten Kennzahlen oder strukturierten Datensätzen liefert eine Kombination verschiedener Methoden häufig bessere Ergebnisse.
Die Search-Architektur sollte sich deshalb am Anwendungsfall orientieren, nicht an einem bestimmten KI-Tool.
Welche Grenzen und Risiken hat Retrieval Augmented Generation?
RAG kann die Qualität generativer KI verbessern. Es löst jedoch nicht automatisch alle Probleme, die beim Einsatz von Large Language Models auftreten.
Eine der größten Herausforderungen liegt in der Qualität der zugrunde liegenden Daten.
Sind Dokumente veraltet, widersprüchlich oder unvollständig, kann das System auch mit einer technisch guten Suche fehlerhafte Antworten erzeugen.
Hinzu kommen weitere Risiken:
- Unpassende Suchergebnisse: Die benötigten Inhalte sind vorhanden, werden aber nicht gefunden.
- Unvollständiger Kontext: Einzelne Textabschnitte werden ohne wichtige Zusammenhänge abgerufen.
- Fehlerhafte Interpretation: Das Sprachmodell versteht eine Quelle falsch oder zieht unbegründete Schlussfolgerungen.
- Falsche Quellenzuordnung: Eine Antwort enthält Quellenangaben, die die konkrete Aussage nicht ausreichend stützen.
- Unzureichende Zugriffsrechte: Vertrauliche Daten könnten unberechtigten Nutzern angezeigt werden.
- Manipulierte Dokumente: Über sogenannte Prompt Injections können schädliche Anweisungen in externe Inhalte eingeschleust werden.
Besonders wichtig ist deshalb, wie das System mit fehlendem Knowledge umgeht.
Wenn die Wissensbasis keine ausreichende Antwort liefert, sollte die Anwendung dies kenntlich machen, statt eine scheinbar sichere Aussage zu erzeugen.
Auch eine nachträgliche Prüfung der generierten Responses ist sinnvoll. Dabei kann beispielsweise kontrolliert werden, ob eine Antwort durch die tatsächlich gefundenen Dokumentstellen gedeckt ist.
| RAG erhöht somit die Möglichkeiten, Antworten auf überprüfbare Quellen zu stützen. Die Verantwortung für Datenqualität, Sicherheit und fachliche Kontrolle bleibt dennoch bestehen. |
Wie sicher sind Unternehmensdaten in einem RAG-System?
Ob RAG für sensible Unternehmensinformationen geeignet ist, hängt von der technischen Architektur und den eingesetzten Diensten ab.
Eine Anwendung kann externe Sprachmodelle, lokal betriebene LLMs oder mehrere kombinierte Komponenten nutzen.
Bei Cloud-Lösungen werden einzelne Dienste auf externer Infrastruktur betrieben. Eine On-Premises-Architektur kann dagegen ermöglichen, KI-Modelle, Suchindizes und Wissensdatenbanken in der eigenen Umgebung zu betreiben.
Vor der Einführung sollten Unternehmen insbesondere klären:
- Wo werden Dokumente, Embeddings und Suchindizes gespeichert?
- Welche Daten werden an das Language Model übertragen?
- Welche externen Cloud-Dienstleister sind eingebunden?
- Wie werden User authentifiziert und Berechtigungen überprüft?
- Können vertrauliche Inhalte durch Suchergebnisse oder Antworten offengelegt werden?
- Wie werden Daten aktualisiert und gelöscht?
- Welche Protokollierungs- und Sicherheitsmaßnahmen sind notwendig?
Besonders wichtig ist die Zugriffskontrolle: Wer ein Dokument nicht einsehen darf, darf dessen Inhalt auch nicht über den KI-Assistenten erhalten. Berechtigungen müssen daher bereits beim Retrieval berücksichtigt werden. Werden personenbezogene Informationen verarbeitet, sind zudem die Anforderungen der DSGVO zu prüfen.
Eine individuelle Entwicklung ermöglicht es, die Architektur gezielt an diese Anforderungen anzupassen. Sicherheit und Rechtskonformität entstehen allerdings erst durch die konkrete technische und organisatorische Umsetzung.
Was kostet die Entwicklung eines RAG-Systems?
Die Kosten hängen nicht allein vom verwendeten KI-Modell ab.
Ein Prototyp mit wenigen Dokumenten ist deutlich anders zu bewerten als eine unternehmensweite Anwendung mit mehreren Wissensquellen, Nutzerrollen und komplexen Berechtigungen.
Wichtige Kostenfaktoren sind:
- Analyse und Konzeption: Definition der Anwendungsfälle, Anforderungen und Erfolgskriterien.
- Datenaufbereitung: Bereinigung, Strukturierung und technische Verarbeitung vorhandener Inhalte.
- Entwicklung der Sucharchitektur: Auswahl und Einrichtung der passenden Retrieval- und Search-Verfahren.
- KI-Modell und Infrastruktur: Kosten für API-Nutzung, Cloud Hosting, Rechenleistung und Speicherung.
- Softwareintegration: Einbindung in vorhandene Anwendungen, Benutzeroberflächen und Schnittstellen.
- Sicherheit und Qualitätssicherung: Berechtigungen, Tests, Monitoring und Schutzmaßnahmen.
- Laufende Betreuung: Aktualisierung der Wissensbasis, Wartung und technische Weiterentwicklung.
Bei produktiven Systemen entstehen meist einmalige Entwicklungs- und laufende Betriebskosten.
Ob sich RAG wirtschaftlich lohnt, hängt vor allem davon ab, wie häufig die Anwendung genutzt wird und wie viel manuellen Aufwand sie tatsächlich reduziert. Ein begrenzter Prototyp kann helfen, Machbarkeit, Antwortqualität und Nutzen vor einer größeren Investition zu prüfen.
Wann ist RAG sinnvoll und wann reicht eine klassische Suche?
Nicht jede Knowledge Base benötigt künstliche Intelligenz.
Eine klassische Dokumentensuche reicht häufig aus, wenn Nutzer nach eindeutigen Begriffen suchen und lediglich passende Dateien öffnen möchten. RAG bietet insbesondere dann Mehrwert, wenn Inhalte aus mehreren Quellen zusammengeführt und als verständliche Antwort ausgegeben werden sollen.
Ein RAG-System kann sinnvoll sein, wenn:
- zahlreiche Dokumente und Wissensquellen vorhanden sind,
- Unternehmensdaten regelmäßig aktualisiert werden,
- Mitarbeiter häufig ähnliche Fachfragen stellen,
- Inhalte in unterschiedlichen Systemen gespeichert sind,
- Antworten mehrere Dokumente berücksichtigen müssen,
- Quellen nachvollziehbar angegeben werden sollen.
Für exakte Berechnungen, strukturierte Datenbankabfragen oder fest definierte Entscheidungen können klassische Softwarefunktionen besser geeignet sein. Auch Kombinationen sind möglich: Eine Anwendung kann aktuelle Bestelldaten direkt aus einer Datenbank abrufen und ergänzende Fragen zu Bestellrichtlinien über RAG beantworten.
Entscheidend ist, welche Technologie den konkreten Prozess am zuverlässigsten unterstützt.
Wie lässt sich ein RAG-System im Unternehmen einführen?
Eine erfolgreiche Einführung beginnt mit einem klar abgegrenzten Anwendungsfall.
Anstatt sofort sämtliche Unternehmenssysteme anzubinden, empfiehlt sich zunächst ein begrenzter Pilotbereich mit überprüfbaren Zielen.
Schritt 1: Das Problem definieren
Welche Daten werden regelmäßig gesucht? Wie lange dauert die Recherche aktuell? Welche Fragen soll das System zuverlässig beantworten können?
Schritt 2: Die vorhandenen Daten prüfen
Im nächsten Schritt werden die relevanten Dokumente und Datenquellen analysiert. Dabei geht es um Aktualität, Vollständigkeit, Struktur und Zugriffsberechtigungen.
Schritt 3: Die technische Architektur festlegen
Nun wird entschieden, welche Retrieval-Verfahren, Language Models, Speicherlösungen und Schnittstellen notwendig sind.
Schritt 4: Einen Prototyp entwickeln
Ein begrenzter Prototyp ermöglicht erste Tests mit realistischen Fragen. So lässt sich früh erkennen, ob die relevanten Dokumente gefunden und korrekt verarbeitet werden.
Schritt 5: Antwortqualität systematisch messen
Für die Bewertung werden realistische Testfragen mit erwarteten Antworten und überprüfbaren Quellen vorbereitet.
Dabei sind unter anderem folgende Kriterien hilfreich:
- Werden die benötigten Daten gefunden?
- Stimmen die generierten Responses mit den Quellen überein?
- Werden fehlende Inhalte richtig erkannt?
- Sind die Antworten für Nutzer verständlich und fachlich korrekt?
- Wie lange dauert die Verarbeitung einer Anfrage?
Schritt 6: Integration und laufenden Betrieb vorbereiten
Nach erfolgreichen Tests kann die Anwendung in bestehende Prozesse integriert werden. Auch im laufenden Betrieb müssen Suchqualität, Antwortgenauigkeit und Aktualität regelmäßig überprüft werden.
RAG und KI-Agenten: Wie hängen beide Technologien zusammen?
Retrieval Augmented Generation wird häufig zusammen mit KI-Agenten eingesetzt. Die Technologien erfüllen jedoch unterschiedliche Aufgaben.
RAG liefert relevantes Wissen aus externen Quellen. KI-Agenten können zusätzlich Aufgaben planen, Werkzeuge verwenden und definierte Aktionen ausführen. Ein Agent könnte beispielsweise eine Supportanfrage analysieren, über RAG technische Dokumentationen durchsuchen und anschließend eine Antwort vorbereiten oder ein Ticket anlegen.
Die Retrieval-Komponente stellt dabei das benötigte Wissen bereit, während der Agent weitere Prozessschritte koordiniert. Diese Kombination eignet sich für komplexere Workflows, stellt aber höhere Anforderungen an Sicherheit und Kontrolle.
Wenn lediglich Fragen zu bestehenden Dokumenten beantwortet werden sollen, reicht häufig ein klassischer RAG-Chatbot aus.
Individuelle RAG-Lösungen für bestehende Unternehmenssoftware
Eine RAG-Anwendung ist besonders dann hilfreich, wenn sie nicht als isolierter Chatbot betrieben wird, sondern in die vorhandene Softwarelandschaft eingebunden werden kann.
Unternehmen verwenden häufig unterschiedliche Systeme für Dokumentation, Verwaltung und operative Prozesse. Damit ein KI-Assistent zuverlässig auf diese Daten zugreifen kann, sind passende Schnittstellen, eine durchdachte Datenarchitektur und klare Zugriffsregeln erforderlich.
Hier kann individuelle Softwareentwicklung sinnvoll sein.
codecan solutions entwickelt individuelle Software- und KI-Lösungen, bei denen bestehende Anwendungen und Datenquellen in die technische Analyse einbezogen werden können. Dazu gehören auch Lösungen, die Large Language Models und Retrieval-Verfahren miteinander kombinieren.
Die Zusammenarbeit beginnt mit einer gemeinsamen Analyse. Anschließend werden die technischen Möglichkeiten bewertet, die Anwendung schrittweise umgesetzt und anhand von Tests sowie Feedback weiterentwickelt.
Dabei profitieren Unternehmen vom direkten Kontakt zu den deutschsprachigen Entwicklern, der internen Umsetzung ohne Outsourcing und der langfristigen Betreuung nach der Einführung.
Ob dafür ein individuell entwickeltes RAG-System notwendig ist oder eine bestehende Lösung ausreicht, sollte anhand des tatsächlichen Anwendungsfalls entschieden werden.
Retrieval Augmented Generation gezielt für Unternehmenswissen nutzen
Retrieval Augmented Generation verbindet generative KI mit vorhandenen Wissensquellen. Damit können Unternehmen interne Dokumentationen leichter durchsuchen, Fachfragen schneller beantworten und bestehendes Wissen gezielter nutzen.
Entscheidend sind eine gepflegte Knowledge Base, zuverlässige Suchverfahren, sichere Schnittstellen und überprüfbare Antworten, denn RAG ersetzt kein gutes Datenmanagement, kann vorhandene Informationen aber deutlich einfacher zugänglich machen.
Wenn du prüfen möchtest, wie Retrieval Augmented Generation in deinem Unternehmen eingesetzt werden kann, unterstützt dich codecan solutions bei der Analyse, Konzeption und Entwicklung einer passenden KI-Lösung.
Häufige Fragen zu Retrieval Augmented Generation (RAG)
Was bedeutet Retrieval Augmented Generation auf Deutsch?
Retrieval Augmented Generation bedeutet sinngemäß „durch Informationsabruf erweiterte Generierung“. Dabei ergänzt ein Sprachmodell seine Antworten um Wissen, das zuvor aus externen Quellen abgerufen wurde.
Kann RAG mit ChatGPT verwendet werden?
Ja. Geeignete GPT-Modelle können über eine API in eine RAG-Anwendung eingebunden werden. Die gefundenen Inhalte werden dem Modell als zusätzlicher Kontext bereitgestellt, bevor es eine Antwort erstellt.
Braucht RAG immer eine Vektordatenbank?
Nein. Neben Vektordatenbanken können auch klassische Suchindizes, Datenbankabfragen oder hybride Search-Verfahren verwendet werden.
Kann RAG falsche KI-Antworten vollständig verhindern?
Nein. RAG kann Halluzinationen reduzieren, aber fehlerhafte Suchergebnisse oder falsch interpretierte Quellen können weiterhin zu unzutreffenden Aussagen führen.
Werden Unternehmensdaten beim Einsatz von RAG zum Training verwendet?
Nicht zwangsläufig. RAG erfordert kein erneutes Training des Sprachmodells mit Unternehmensdaten. Wie externe Anbieter übertragene Inhalte speichern oder verwenden dürfen, hängt von den jeweiligen Diensten und Vertragsbedingungen ab.
Was unterscheidet einen RAG-Chatbot von einem normalen Chatbot?
Ein RAG-Chatbot durchsucht bei einer Anfrage angebundene Wissensquellen. Ein Chatbot ohne Retrieval-Funktion nutzt dagegen hauptsächlich das Modellwissen und den vorhandenen Gesprächskontext.
Wie werden neue Dokumente in ein RAG-System integriert?
Neue oder aktualisierte Dokumente werden erfasst und für die Suche aufbereitet. Das kann über automatische Synchronisierung oder regelmäßige Aktualisierungsprozesse erfolgen. Ein erneutes Modelltraining ist normalerweise nicht erforderlich.
Kann ein RAG-System ohne Cloud betrieben werden?
Ja, wenn alle notwendigen Komponenten lokal betrieben werden. Dazu gehören das Sprachmodell, die Suchtechnologie und die Wissensbasis. Ob sich das lohnt, hängt von den technischen und wirtschaftlichen Anforderungen ab.
Du möchtest klären, ob für deine Anforderungen eine bestehende Software ausreicht oder eine neue individuelle Anwendung sinnvoll ist? Im kostenlosen Erstgespräch können Ziele, Anforderungen und mögliche nächste Schritte gemeinsam eingeordnet werden.